
База знаний
Внутренняя SEO-оптимизация сайта
Теги, перелинковка, robots.txt и структура — база, без которой внешние ссылки не дают ничего.
- 14 сентября 2026
- 15 мин чтения
Публикации
Внутренняя SEO-оптимизация сайта
«Ми купили посилання, а позиції стоять на місці» — з цією фразою до нас приходять частіше, ніж з будь-якою іншою. Під час аудиту картина майже завжди схожа: однакові title на половині сторінок, каталог, у якому важливі розділи сховані на п’ятому рівні вкладеності, robots.txt, що випадково закриває пів сайту, і тисячі дублів, між якими пошукова система не може вибрати потрібну сторінку. Зовнішні посилання в такій ситуації схожі на воду, яку ллють у діряве відро.
Внутрішня оптимізація — це все, що ви контролюєте на власному сайті: теги, структура, адреси, перелінковка, керування індексацією, мікророзмітка, зображення. Вона не така помітна, як нові тексти чи реклама, але саме вона визначає, чи зрозуміє пошукова система, про що ваші сторінки і які з них головні. Нижче — те, що ми перевіряємо й виправляємо в кожному проєкті, у тому порядку, в якому радимо це робити.
Чому без внутрішньої бази посилання не працюють
Пошукова система проходить три етапи: знаходить сторінку (сканування), додає її в базу (індексація) і вирішує, на яке місце її поставити (ранжування). Зовнішні посилання впливають переважно на третій етап. Але якщо сторінка не сканується, не потрапляє в індекс або конкурує з власним дублем, посиланню просто нема чого підсилювати.
Ось як це виглядає на практиці:
- Посилання веде на сторінку, яка віддає редирект на інший редирект, — частина ваги губиться по дорозі.
- Сторінка має три версії адреси (з www і без, зі слешем і без) — вага ділиться між ними.
- На просувану сторінку немає жодного внутрішнього посилання — робот вважає її другорядною.
- Title не містить запиту, під який купували посилання, — пошукова система не пов’язує сторінку з цим запитом.
Тому ми завжди починаємо з внутрішньої оптимізації і лише потім беремося за зовнішні фактори. Про правильну послідовність робіт ми докладно писали у статті «Методи та порядок дій при розкручуванні».
Title, description і заголовки H1–H3
Це перше, що бачить і людина в результатах пошуку, і робот на сторінці. Помилки тут найдешевше виправити і найдорожче ігнорувати.
Title — головний текстовий сигнал сторінки. Ми ставимо основний запит ближче до початку, додаємо уточнення, яке відрізняє сторінку від конкурентів (ціна, регіон, перевага), і назву бренду в кінці. Кожен title на сайті має бути унікальним. Якщо сторінок сотні, ми пишемо шаблон, а для найважливіших — формулюємо заголовок вручну.
Description напряму на позиції не впливає, але впливає на те, чи клікнуть на ваш сніпет. Це рекламне оголошення в результатах пошуку: що людина отримає, чим ви кращі, який наступний крок. Пошукова система може замінити його фрагментом тексту, але добре написаний опис вона показує частіше.
H1 — один на сторінку, він відповідає на запит і збігається за змістом із title, але не обов’язково дослівно. H2 і H3 будують логічну структуру тексту: розділи й підрозділи. Ми часто бачимо, як заголовні теги використовують для оформлення — «Підписатися на розсилку» в H2 у підвалі чи назви товарів у слайдері в H1. Робот читає це як структуру сторінки, тож вона стає незрозумілою.
| Елемент | Орієнтир | Типова помилка |
|---|---|---|
| title | 50–65 символів, запит на початку | Однаковий шаблон без назви товару чи послуги |
| description | 120–160 символів, вигода й заклик | Порожній або скопійований на всі сторінки |
| H1 | Один на сторінку, відповідає на запит | Логотип у H1 або кілька H1 у шаблоні |
| H2–H3 | Логічні розділи тексту | Теги заголовків для оформлення блоків |
| alt зображень | Короткий опис того, що на фото | Список ключових слів через кому |
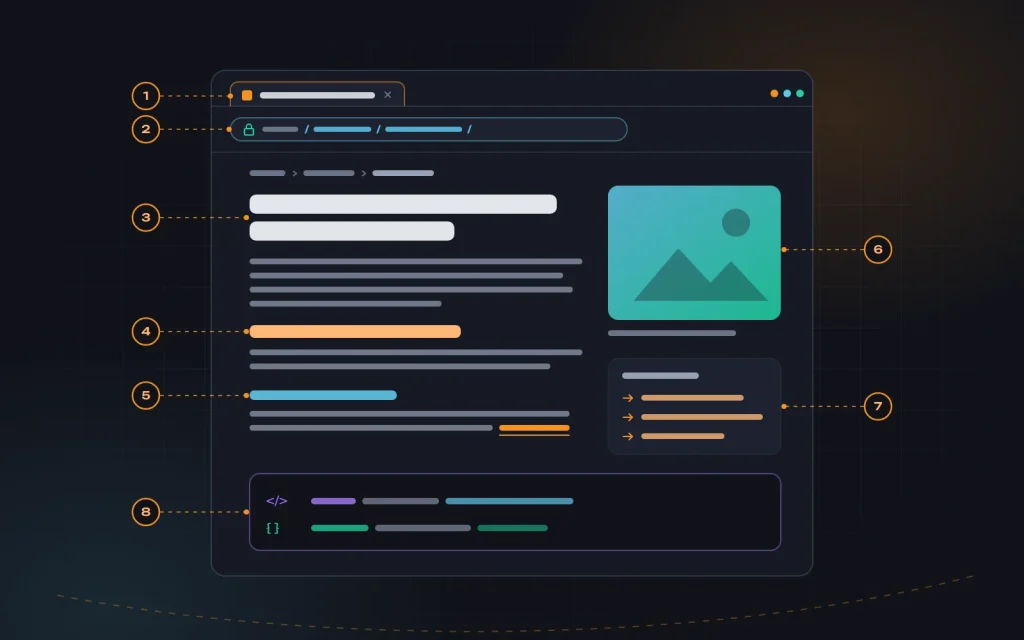
Ще одна деталь, яку ми перевіряємо одразу: заголовки й основний текст мають бути в HTML-коді, який віддає сервер, а не підвантажуватися скриптом після кліку чи прокручування. Пошукові системи вміють обробляти JavaScript, але роблять це із затримкою і не завжди повністю. Якщо ключовий текст з’являється лише після взаємодії, ризикуєте, що робот його не побачить.
Як зрозуміти, які сторінки виправляти першими? Ми відкриваємо в Search Console звіт «Результати пошуку» і шукаємо сторінки з великою кількістю показів, але низьким CTR, а також ті, що стоять на позиціях 5–15. Для них новий title і description часто дають помітний приріст кліків без жодних інших змін. Через кілька тижнів порівнюємо показники до й після — і вирішуємо, чи переносити вдале формулювання на шаблон для схожих сторінок.
Структура сайту та адреси сторінок
Структура — це карта, за якою і людина, і робот розуміють, що на сайті головне. Ми будуємо її від попиту: кожна група запитів, на яку пошукова система показує окремі сторінки, отримує власну сторінку на сайті. Як зібрати й згрупувати запити — у статті «Готуємо семантичне ядро самостійно».
Наші базові правила для структури:
- Не глибше трьох кліків від головної до будь-якої важливої сторінки. Чим глибше сторінка, тим рідше її сканують і тим менше ваги вона отримує.
- Одна сторінка — одна тема. Дві сторінки під той самий запит конкурують між собою, і зазвичай жодна не виходить у топ.
- Логічна вкладеність: розділ → категорія → підкатегорія чи сторінка послуги. Хлібні крихти на кожній сторінці показують цей шлях.
- Жодних «сиріт» — сторінок, на які не веде жодне внутрішнє посилання.
Адреси ми робимо короткими, зрозумілими й стабільними: латиницею, через дефіс, без параметрів і службових ідентифікаторів. Наприклад, /poslugy/remont-pokrivli/ замість /index.php?cat=12&id=487. Обираємо один формат — з кінцевим слешем або без, з www або без, лише HTTPS — і всі інші варіанти перенаправляємо на нього 301-редиректом.
Найважливіше правило щодо URL: змінювати їх лише тоді, коли це справді потрібно, і завжди з редиректами. Ми регулярно бачимо, як після редизайну чи переїзду на нову CMS сайт втрачає більшу частину органіки саме через те, що старі адреси почали віддавати 404.
Тому перед будь-якою зміною структури ми складаємо таблицю відповідності: кожна стара адреса — нова адреса. Особливу увагу приділяємо сторінкам, які мають зовнішні посилання й трафік: вони мають вести на максимально близьку за змістом сторінку, а не масово на головну. Після запуску проходимо сайт краулером і перевіряємо, що жодне внутрішнє посилання не веде на редирект чи на неіснуючу сторінку.
Внутрішня перелінковка
Внутрішні посилання виконують три завдання: допомагають роботу знайти сторінки, розподіляють вагу між ними і підказують, про що сторінка, через текст посилання. Це той інструмент, яким ви повністю керуєте самі й безкоштовно.
Як ми вибудовуємо перелінковку:
- Меню й підвал — для ключових розділів. Головне меню не повинно містити сотню пунктів: туди виносимо основне, глибші рівні показуємо всередині розділів.
- Хлібні крихти — шлях від сторінки до головної, корисний і людям, і роботу.
- Посилання в тексті — найцінніші. Стаття в блозі посилається на сторінку послуги там, де це логічно для читача, а сторінка послуги — на розбір частих запитань.
- Блоки «схожі» та «супутні» — для каталогів і блогів, щоб сторінки одного рівня були пов’язані між собою.
Текст посилання має пояснювати, куди воно веде. «Детальніше» чи «тут» не кажуть нічого ні людині, ні пошуковій системі. «Ціни на ремонт покрівлі» — кажуть. Водночас не варто ставити десятки однакових точних анкорів: природна різноманітність формулювань виглядає краще і читається легше.
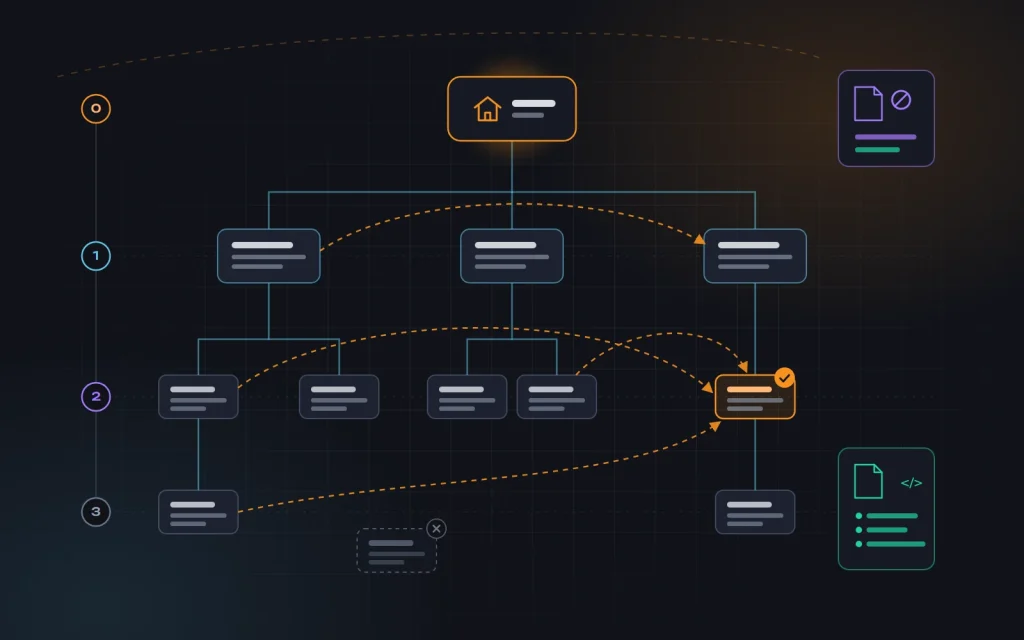
Окремо ми перевіряємо, куди веде вага. Сторінки, з яких ви заробляєте, мають отримувати найбільше внутрішніх посилань. На практиці часто навпаки: найбільше посилань отримують «Політика конфіденційності» й «Умови доставки» з підвалу, а головна послуга — одне посилання з меню. Аналіз сайту краулером (Screaming Frog, Netpeak Spider чи аналогом) за годину показує цей перекіс.
robots.txt, sitemap.xml і керування індексацією
Ці два файли кажуть роботу, куди ходити не варто і які сторінки ви вважаєте важливими. Вони прості, але помилка в них може обнулити всю роботу.
robots.txt лежить у корені сайту й обмежує сканування. Ми закриваємо в ньому кошик, особистий кабінет, внутрішній пошук, службові параметри сортування й сесій. І ніколи не закриваємо стилі, скрипти та зображення: без них робот бачить сторінку зламаною і може оцінити її гірше. Найнебезпечніша помилка, яку ми бачимо після запуску нових сайтів, — рядок Disallow: /, що лишився з тестового сервера.
Важливо розуміти різницю: robots.txt забороняє сканувати, але не гарантує, що сторінки не буде в індексі. Якщо сторінку треба прибрати з пошуку, їй потрібен noindex у метатегу robots або в заголовку відповіді сервера, а сама вона має бути доступною для сканування, інакше робот цей noindex просто не побачить.
sitemap.xml — список сторінок, які ви хочете бачити в пошуку. Наші правила для карти сайту:
- Лише сторінки з кодом відповіді 200, відкриті для індексації й канонічні.
- Жодних редиректів, 404, службових фільтрів чи сторінок з noindex.
- Автоматичне оновлення при додаванні чи видаленні сторінок.
- Посилання на карту в robots.txt і її додавання в Google Search Console.
Після цього раз на місяць ми дивимося звіт про індексацію в Search Console. Різке зростання кількості сторінок «Проскановано, але не проіндексовано» або несподівані тисячі нових адрес майже завжди означають технічну проблему, яку краще знайти раніше, ніж вона вдарить по позиціях. Там же видно, яку адресу Google обрав канонічною для конкретної сторінки, — якщо вона не збігається з вашою, це сигнал шукати дублі. А інструмент перевірки URL показує, як робот бачить сторінку: чи доступна вона, чи є noindex і чи завантажився основний вміст.
Дублі, canonical і редиректи
Дубль — це той самий або майже той самий вміст за різними адресами. Він з’являється частіше, ніж здається: через параметри сортування й UTM-мітки, версії для друку, різні шляхи до одного товару, сторінки пагінації, копії з www і без. Пошукова система сама вибирає, яку версію показувати, і далеко не завжди ту, яку обрали б ви.
Ми працюємо з дублями трьома інструментами:
| Ситуація | Рішення |
|---|---|
| Сторінка переїхала назавжди або змінився формат адреси | 301-редирект на нову адресу |
| Кілька версій сторінки мають існувати (параметри, сортування, UTM) | rel=»canonical» на основну версію |
| Службова сторінка корисна людям, але не потрібна в пошуку | noindex, follow |
| Сторінки більше немає й заміни теж | Код 404 або 410 |
Тег <link rel="canonical"> ставимо на кожну сторінку, зокрема з посиланням на саму себе, — це захищає від дублів, створених параметрами. Канонічна адреса має бути абсолютною, відкритою для індексації і віддавати код 200. Найдорожча помилка, яку ми бачили, — canonical у шаблоні, що на всіх сторінках вказував на головну: за кілька тижнів сайт фактично зник з пошуку.
З редиректами головне правило — без ланцюжків. Якщо адреса A веде на B, а B на C, ми переписуємо редирект так, щоб A вела одразу на C, і оновлюємо внутрішні посилання на кінцеву адресу. Тимчасові 302-редиректи використовуємо лише для справді тимчасових ситуацій. Для багатомовних сайтів додаємо hreflang: кожна мовна версія має свою адресу й посилається на інші, інакше їх можуть сприйняти як дублі.
В інтернет-магазинах дублів особливо багато через фільтри, сортування й варіанти товарів. Там ми розділяємо фільтри на ті, що мають реальний попит і заслуговують на окрему сторінку, і службові, які закриваємо від індексації. Детально цю схему ми розбирали у статті «П’ять порад для просування магазину».
Мікророзмітка та зображення
Структуровані дані (Schema.org у форматі JSON-LD) пояснюють пошуковій системі, що саме на сторінці: організація, товар, стаття, відгук, хлібні крихти, запитання й відповіді. Прямим фактором ранжування розмітка не є, але вона дає розширені сніпети — ціну, рейтинг, наявність, — які помітніші в результатах пошуку й частіше отримують кліки.
Мінімальний набір, який ми впроваджуємо на більшості сайтів:
- Organization або LocalBusiness — назва, логотип, контакти, адреса.
- BreadcrumbList — для всіх сторінок з хлібними крихтами.
- Product з Offer — для карток товарів: ціна, валюта, наявність.
- Article — для статей блогу.
Головне правило: розмітка має відповідати тому, що людина бачить на сторінці. Рейтинг без реальних відгуків чи ціна, якої немає в тексті, — це порушення правил, за яке можна втратити розширені сніпети для всього сайту. Перевіряємо результат у Rich Results Test і звіті «Покращення» в Search Console.
Зображення впливають і на швидкість, і на пошук за картинками. Ось що ми робимо з ними:
- Зрозумілі назви файлів латиницею:
chervona-chereptsia.webp, а неIMG_4587.jpg. - Атрибут alt — короткий опис того, що на зображенні, без переліку ключових слів.
- Сучасні формати WebP чи AVIF і стиснення без помітної втрати якості.
- Адаптивні розміри через srcset, щоб телефон не завантажував фото для широкого монітора.
- Задані ширина й висота, щоб макет не «стрибав» під час завантаження.
- Ліниве завантаження для всього, крім головного зображення першого екрана.
Швидкість загалом — окрема велика тема, якою ми займаємося в межах послуги оптимізації сайту. А про те, як оцінювати мобільну версію, ми писали у статті «Як досягти успіху в mobile-first index».
Як це виглядає на практиці
Типова ситуація: сайт компанії, що надає будівельні послуги, близько двохсот сторінок, кілька місяців платних посилань — і жодного помітного руху. Під час аудиту ми бачимо, що сайт доступний за чотирма варіантами адреси, усі сторінки послуг мають title «Послуги — Назва компанії», основні послуги лежать на четвертому рівні вкладеності й отримують одне внутрішнє посилання з меню, а карта сайту містить кілька десятків адрес з редиректами.
Ми налаштовуємо єдину версію адреси, переписуємо title і description для ключових сторінок, перебудовуємо меню так, щоб послуги були в одному кліку від головної, додаємо перелінковку з блогу, чистимо карту сайту й додаємо мікророзмітку. Спочатку змінюється індексація: потрібні сторінки сканують частіше, сміття зникає з індексу. Далі ростуть покази й кліки за запитами, під які сторінки оптимізовані. І лише тепер посилання починають працювати так, як очікувалося. Конкретні цифри залежать від ніші й конкуренції, тому обіцяти їх наперед ми не будемо.
Шість помилок, які ми бачимо найчастіше
- Тестовий сайт у індексі або закритий робочий. Після запуску копія з тестового домену потрапляє в пошук, а на основному лишається заборона сканування.
- Зміна структури без карти редиректів. Старі адреси віддають 404, і накопичена роками вага зникає.
- Однакові мета-теги на десятках сторінок. Пошукова система не розуміє, яку сторінку показувати за запитом.
- Перелінковка лише через меню. Важливі сторінки отримують стільки ж посилань, скільки й другорядні.
- Розмітка, що не відповідає сторінці. Зірочки без відгуків чи вигадані ціни — прямий шлях до санкцій.
- Важкі зображення без розмірів. Повільне завантаження і «стрибаючий» макет на телефоні.
Короткий чек-лист
- Сайт доступний лише за однією адресою: HTTPS, один варіант www і слеша.
- Кожна сторінка має унікальні title, description і один H1.
- Важливі сторінки — не далі трьох кліків від головної, «сиріт» немає.
- robots.txt не закриває потрібні розділи, стилі й скрипти.
- sitemap.xml містить лише канонічні сторінки з кодом 200.
- На кожній сторінці є коректний canonical, ланцюжків редиректів немає.
- Є базова мікророзмітка, вона проходить перевірку без помилок.
- Зображення стиснені, мають alt, розміри й ліниве завантаження.
- Search Console підключена, звіт про індексацію переглядається щомісяця.
Часті запитання
Скільки часу займає внутрішня оптимізація?
Аудит невеликого сайту — кілька днів, впровадження — від кількох тижнів до кількох місяців, залежно від CMS і обсягу. Перші зміни в індексації зазвичай помітні за 2–6 тижнів після виправлень. Але це не разова дія: при кожному новому розділі чи редизайні базу треба перевіряти знову.
Чи можна зробити це самостійно?
Частково — так. Унікальні title, alt для зображень, базову перелінковку й підключення Search Console власник цілком може зробити сам. А от редиректи при зміні структури, canonical і robots.txt краще доручити тому, хто розуміє наслідки. Детальніше — у статті «Самостійне просування: як це працює».
Чи потрібні ключові слова в мета-тегу keywords?
Ні. Google його не враховує. Ми не витрачаємо на нього час і не радимо вам. Набагато важливіше, щоб запит був у title, H1 і природно звучав у тексті.
Що робити першим, якщо часу мало?
Перевірити, що сайт індексується: robots.txt, noindex, єдина версія адреси, карта сайту. Потім — title і H1 для 10–20 сторінок, які приносять або мають приносити найбільше заявок. Ці два кроки дають найбільший ефект за найменших витрат.
Підсумок
Внутрішня оптимізація — це фундамент: зрозумілі теги, логічна структура, продумана перелінковка, чисті robots.txt і sitemap.xml, керовані дублі, мікророзмітка й легкі зображення. Без неї зовнішні посилання підсилюють хаос, а з нею кожне нове посилання й кожен новий текст працюють на повну силу.
Якщо хочете, щоб ми перевірили ваш сайт і склали список конкретних виправлень, — напишіть нам. Внутрішню оптимізацію ми робимо як окремо, так і в межах комплексного просування сайтів, а для нових проєктів закладаємо її ще на етапі розробки.
Нужна консультация?
Расскажите о задаче — подскажем, что делать, даже если работать будете не с нами.